1. はじめに
写真なら画像で、文章ならキーワードで検索します。それでは、分子はどう探せばよいのでしょうか。化学の資料には構造式、化学名、性質の説明が混在しています。同じ物質の情報でも、書き方が違うと結びつけるのに手間がかかります。
そこで注目されるのが、分子の構造を文字列として読み、説明文や構造図と結びつけるAIです。研究者の言葉を検索につなぐだけでなく、構造を表す文字列から性質を予測する研究も進んでいます。
ただし、「文字列」には二つの意味があります。一つは人が使う文章、もう一つは化学構造を記号で記す専用の表現です。本記事ではこの違いを押さえながら、分子情報を「読み、探し、予測する」仕組みを、三つの特許から読み解きます。
2. 分子構造を読むAIの基本原理
2-1. 分子の設計図を、一列の文字に置き換える
分子の構造式は、どの原子がどのようにつながるかを示す設計図です。このつながりを、文字列で記す方法の一つがSMILESです。原子を元素記号で、枝分かれを括弧などで表し、二次元の図を一列の文字に置き換えます。文章を処理するAIにも入力しやすい点が特徴です。
一方、文字を自由につなげると、結合の規則に合わない構造ができる場合があります。SELFIESは、定められた結合の制約を満たす構造へ変換できるよう設計された表現です。いわば、書き間違いに強い化学の記法といえます。ただし、規則に合う構造であることと、実際に合成できることは別です。
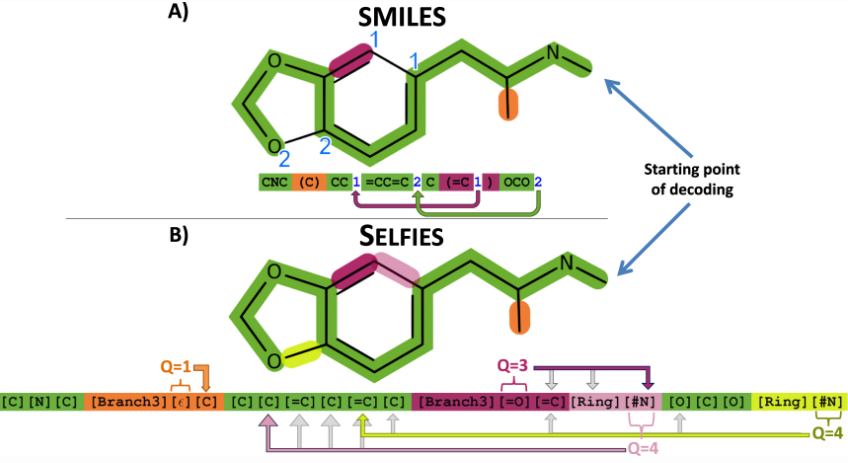
図1 (https://iopscience.iop.org/article/10.1088/2632-2153/aba947)
2-2. 構造と説明文に、共通の「索引」をつける
構造を文字にできても、人の説明文とそのまま照合できるわけではありません。そこで、構造と文章をそれぞれ数値の並びに変え、対応する組み合わせが近くなるように学習させます。この数値表現を「埋め込み」と呼びます。
研究モデルMoleculeSTMは、分子構造と説明文を一緒に学習し、文章から分子を探す検索や、文章の指示に沿った構造の編集を扱いました。別々だった「構造式の棚」と「説明文の棚」に、共通の索引をつけるイメージです。
ここで得られる近さは、学習した情報に基づく対応関係です。検索で近くに並ぶ分子が、同じ性能を持つとは限りません。それでも、異なる形式の情報を結びつける入口として重要な仕組みです。
2-3. 構造を説明し、説明から構造を生成する
検索から一歩進めた例がMolT5です。文章と分子の文字列を使って事前学習し、その後、「分子から説明文をつくる」「説明文から分子を生成する」という二方向の課題を学習します。
下図の上段は、文章や分子文字列の一部を隠して復元する事前学習、下段は目的別の追加学習です。構造の読み方と文章の書き方を学び、両者の対応へつなげています。これは分子の説明や候補づくりを支援する研究であり、生成した物質の有効性を証明する仕組みではありません。
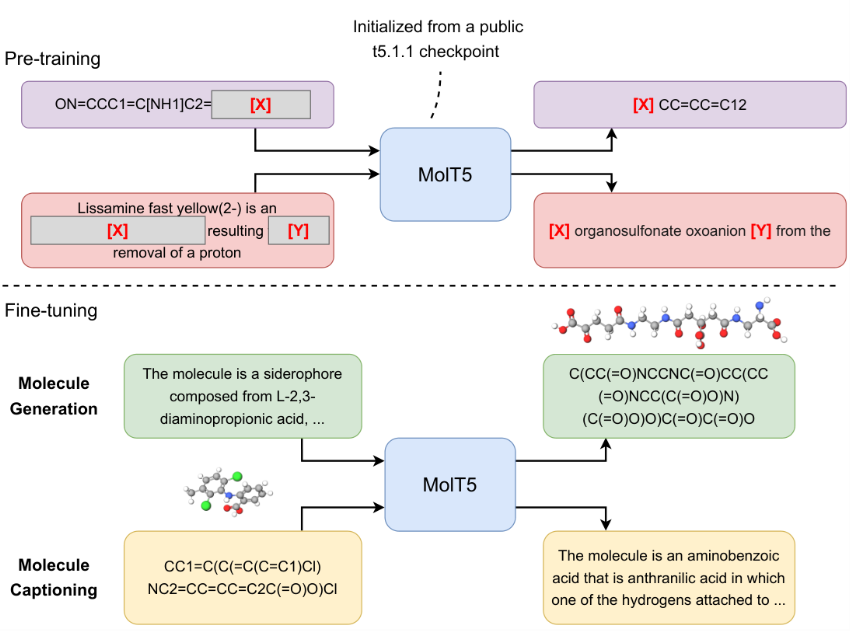
図3 (https://arxiv.org/html/2204.11817v3)
3. 特許から見る技術革新
3-1. 構造情報を共通形式に整える:US12481658B1
IBMのこの特許は、化学構造の記述を、データベースで扱える共通形式へ変換する技術です。最初のモデルが文章などから原子と結合のデータ構造をつくり、次のモデルが化学分野向けの記述形式へ変換します。その記述を使って、データベースへ問い合わせます。
工夫は、入力した文章を直接検索するのではなく、原子と結合の関係をいったん整理することです。化学の文章と構造式は見た目が違っても、背後にある原子のつながりを共通の手掛かりにできます。
たとえるなら、品名が違う部品を、形状と接続関係のそろった部品表に書き直す方法です。この特許が担うのは、性質の予測ではなく、その前提になる情報の整備と検索です。
3-2. 図と文章の違いを越えて探す:CN120032757B
北京信息科技大学のこの特許は、化合物の構造図、SMILES、自然言語の説明を対象とする検索技術です。画像と文章を対応づけるCLIP型のモデルを使い、それぞれを共通の数値空間へ配置します。
学習では、同じ化合物を示す図と文章の組を近づけ、異なる化合物の組を遠ざけます。検索時には、入力を数値化し、データベースから類似度の高い候補を取り出します。
ポイントは、図と文字列を別々の検索箱に入れるのではなく、異なる入口から同じ候補群へアクセスすることです。ただし、類似度による検索なので、化学的な同一性や目的の性能まで保証するものではありません。
3-3. 化学の文字列から、混合物の形成を予測する:US20240112763A1
クレムソン大学の公開特許は、成分を混ぜることで融点が大きく下がる「深共晶溶媒」に着目しています。どの成分をどの割合で混ぜれば、安定した液体になるのか。その候補をAIで絞り込む提案です。
明細書では、成分のSMILESや配合情報を用い、Transformerという言語処理にも使われるモデルで、混合物の形成・安定性を予測する例が説明されています。大量の化学データで事前学習し、対象の溶媒データで学び直します。
前の二件が「整える」「探す」なら、こちらは「予測する」技術です。自由な文章で会話するAIではありません。明細書には、選んだ10混合物のうち8混合物が室温で少なくとも1週間、透明な液体を保ったとの例があります。ただし、小規模な確認結果であり、安全性やあらゆる組み合わせでの精度を示すものではありません。
4. 応用分野と実用化への道筋
4-1. 化合物検索:手元の情報から候補へたどり着く
調べたい物質の情報が、いつも同じ形式で手元にあるとは限りません。構造図だけがある場合も、文章で特徴が説明されている場合もあります。形式をまたぐ検索は、入力を検索先に合わせて書き直す負担を減らす方向の技術です。
また、構造の近い候補を集められれば、比較する対象を見つけやすくなります。検索結果を出発点に、構造や文献情報を詳しく確認する。そんな調査の入口を広げることが期待されます。
4-2. 溶媒・材料開発:少ないデータで予測を始める
新しい材料の研究では、十分な実験データが集まらないこともあります。Jablonkaらの研究は、化学の問いと答えを文章形式に整え、追加学習したGPT-3で分類、数値予測、逆設計を扱いました。
検討した課題では、特にデータの少ない条件で、従来の機械学習に匹敵する、あるいは上回る結果が示されています。狙いは「AIなら何でもわかる」ことではなく、既に学習したモデルを利用して、少量の専門データから予測を始めることです。下図は対象と課題の整理であり、性能比較のグラフではありません。
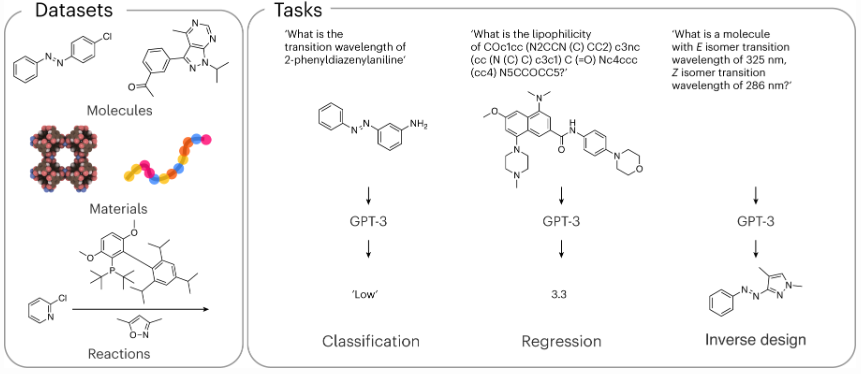
図1 (https://www.nature.com/articles/s42256-023-00788-1)
4-3. 創薬研究:文章を手掛かりに構造を検討する
創薬研究では、候補の分子構造を変えながら、求める性質に近づける検討が続きます。MoleculeSTMの文章による分子編集や、MolT5の文章からの分子生成は、この候補づくりを支援する研究です。
たとえば、構造を示すだけでなく、どのような特徴を求めるかを文章で伝えられれば、候補を検討する新しい入口になります。ただし、生成された構造は完成した医薬品ではありません。合成の可能性、活性、毒性などの確認へ進むための出発点です。
5. 課題と展望
5-1. 「もっともらしい説明」と「正しい構造」を分ける
文章が自然でも、分子の構造まで正しいとは限りません。MolT5の論文に掲載された生成例でも、文章から得た構造と正解例には違いがあります。下図のように全体が似ていても、一部分の置き換わりを見落とすことはできません。
また、説明文に書かれた働きが、生成した別の分子にも備わるとは限りません。表記の妥当性、構造の一致、性質の裏付けは、別々に確かめる必要があります。
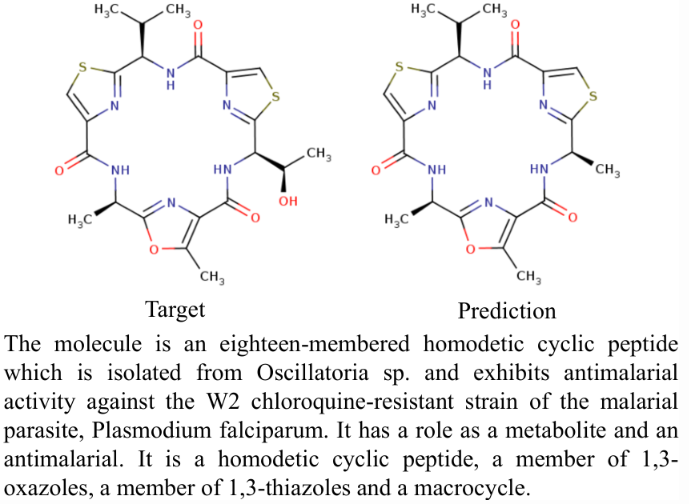
図1 (https://arxiv.org/html/2204.11817v3)
5-2. 研究の最前線は、文字列と立体構造の組み合わせ
2026年の総説では、文字列、原子と結合を表すグラフ、三次元座標など、複数の分子表現が整理されています。同じ分子でもSMILESの書き方が一通りではないため、AIが物質の特徴より表記の癖を学ぶおそれがあります。
一方、文字列だけでは具体的な三次元配置を十分に扱えません。読みやすい文字列と、つながりを示すグラフ、空間を示す座標。それぞれの長所をどう組み合わせるかが、重要な研究課題です。
5-3. 未来の展望:検索・予測・実験をつなぐ研究支援へ
今後期待されるのは、一つのAIにすべてを答えさせることより、検索で候補を集め、適切な予測器で絞り、実験で確かめる流れを支援することです。今回の三つの特許は、その別々の部分に工夫を示しています。
ただし、三件が一つの製品として組み合わされているわけではありません。こうした要素技術が連携すれば、人が問いを立ててから検証へ進むまでの手間を減らせる可能性があります。重要なのは、回答の滑らかさではなく、構造と根拠を確認できることです。
あわせて読みたい
分子を読むAIの先に、実験をどう進める仕組みがあるのか。材料探索と自動実験の解説もどうぞ。
図の情報を整理して説明文に変えるAIは、特許図面でも研究されています。図と言葉を結ぶ別の仕組みを紹介します。
6. 結論
分子を読むAIは、化学構造を文字列へ置き換え、文章や図との対応を学び、検索や予測につなげる技術です。入力を共通形式に整え、図と文章を横断して探し、構造から混合物の形成を予測するーこの三つの特許には、それぞれ異なる課題への工夫が表れています。
分子が言葉で扱えるようになっても、実験が不要になるわけではありません。変わるのは、膨大な候補の中から「次に何を調べるか」を決める入口です。構造式と文章の間に橋を架ける技術が、次世代の化学研究を支える新しい道具になろうとしています。
関連アイテム
分子の違いが身近な物質の性質にどうつながるのか、暮らしや歴史の話題から楽しみたい方にぜひ。
『化学で世界はすべて読み解ける 人類史、生命、暮らしのしくみ (SB新書 631)』
参考文献
テーマに近い関連する特許文献
- US12481658B1 – Creating domain-specific language representations of chemical structures(IBM、2025年発行)
https://patents.google.com/patent/US12481658B1/en - CN120032757B – A method and system for cross-modal search of compound structures(北京信息科技大学、2026年発行)
https://patents.google.com/patent/CN120032757B/en - US20240112763A1 – System and method adapted for the dynamic prediction of NADES formations(Clemson University、2024年公開)
https://patents.google.com/patent/US20240112763A1/en
記事を作成するにあたり参考にした文献
- Machine Learning: Science and Technology(2020)– “Self-referencing embedded strings (SELFIES): A 100% robust molecular string representation”
https://iopscience.iop.org/article/10.1088/2632-2153/aba947 - Proceedings of EMNLP(2022)– “Translation between Molecules and Natural Language”
https://aclanthology.org/2022.emnlp-main.26/ - Nature Machine Intelligence(2023)– “Multi-modal molecule structure–text model for text-based retrieval and editing”
https://www.nature.com/articles/s42256-023-00759-6 - Nature Machine Intelligence(2024)– “Leveraging large language models for predictive chemistry”
https://www.nature.com/articles/s42256-023-00788-1 - Experimental & Molecular Medicine(2026)– “A survey on large language models in biology and chemistry”
https://www.nature.com/articles/s12276-025-01583-1
コメント